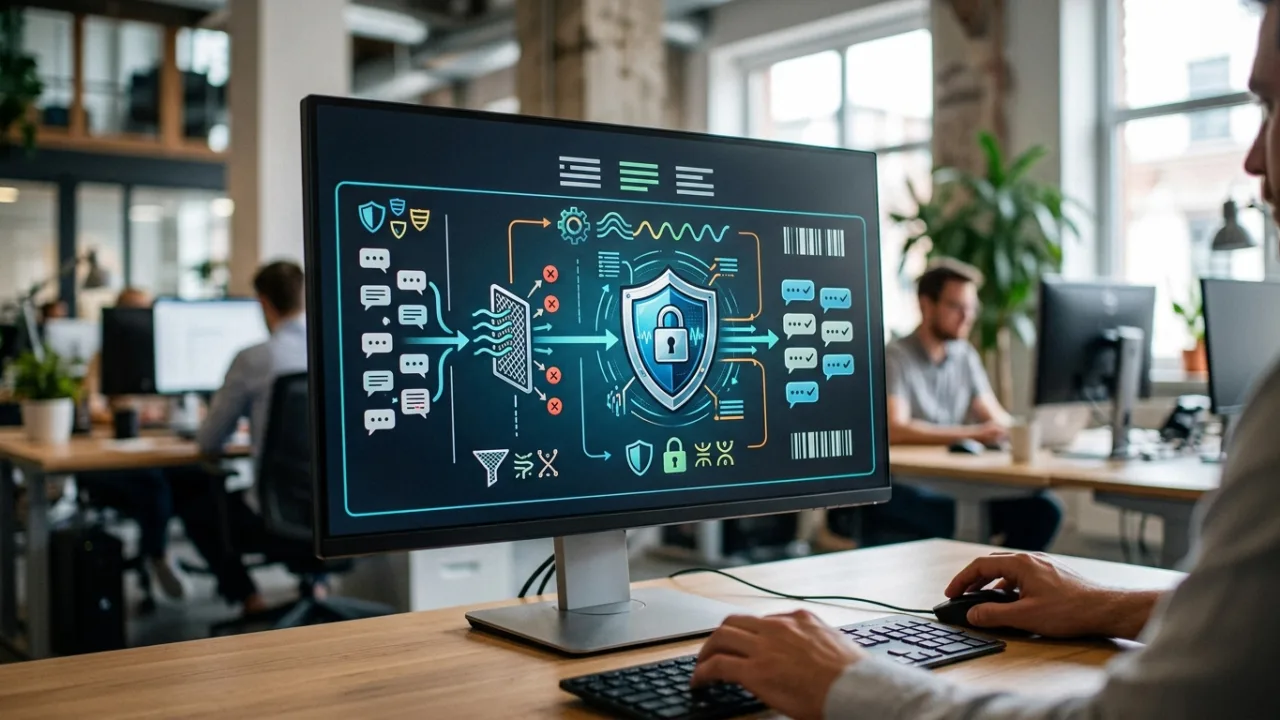
O DoorDash enfrentava um problema matemático duro: mais de quatro milhões de mensagens e quatrocentas mil chamadas por dia entre usuários, entregadores e estabelecimentos, e uma fração pequena de um dígito continha violação de segurança. A resposta foi o SafeChat, uma arquitetura de moderação de IA em duas camadas que cortou os incidentes de abuso verbal pela metade.
Enviar tudo a uma LLM comercial sairia caro e lento demais para chat ao vivo. O SafeChat resolveu com um modelo leve interno, que roda em menos de cem milissegundos e filtra o que é claramente seguro, seguido de uma LLM para os casos suspeitos. O resultado, confirmado pela empresa: 50% menos abuso verbal, com custo e latência viáveis.

O essencial: LLM é ótima em contexto, mas custa e demora para o básico. A solução engenhosa não foi mais modelo, foi arquitetura: filtrar o barato no primeiro andar e deixar a LLM para a exceção. É o padrão de desenho que vem dominando a IA em produção.
Como o DoorDash estruturou a moderação em tempo real
Durante uma entrega, a janela entre mensagem e rusga é de poucos minutos: o contexto é efêmero. Mudar comportamento nesse intervalo dependia de identificar a conversa errada em tempo real, antes que escalasse. A equipe primeiro mapeou o comportamento dos usuários, medindo o que de fato estava errado, e descobriu que a maioria esmagadora das interações era inofensiva. Essa descoberta virou a base da arquitetura.
Por que jogar tudo numa LLM não fecha conta
A proposta inicial, mandar tudo para uma LLM de fora, esbarrou em três problemas. O primeiro é financeiro: milhões de chamadas diárias a modelo pago não comportam margem de um marketplace. O segundo é de latência: chamada de LLM leva de alguns segundos a uma dezena, e chat ao vivo não espera isso. O terceiro é de viés: aplicar o modelo mais pesado a mensagens triviais produz falso positivo em escala. Ficou claro que a resposta não era escolher modelo, era desenhar um pipeline.
# publicidade
O padrão em camadas que resolveu o problema
O desenho final tem duas camadas. A primeira é um modelo interno de aprendizado de máquina, treinado pela casa, que roda em menos de cem milissegundos e resolve o que é claramente seguro, dando tempo para o resto do sistema trabalhar. Só o que acende alerta nessa primeira passada, menos de 10% do total, segue para a segunda camada, uma LLM gerenciada por um gateway interno que cuida de retentativa, rota de contingência e custo. O desenho em camadas, e não o modelo, é o que tornou o sustentável possível.
Pontuação gradual em vez de sim ou não
A saída da LLM não é binária. O sistema marca nível de risco em eixos como assédio, preconceito ou ameaça, e a ação é proporcional: desde uma censura de palavra simples até cancelamento de pedido, dependendo da gravidade. Essa continuidade de score, junto com o backtesting em milhares de conversas históricas, mata dois problemas ao mesmo tempo, o excesso de punição e o excesso de passividade.
ℹ️ Info: a métrica central do SafeChat não foi o volume moderado, e sim a queda real de incidentes. O sucesso largamente veio de medir o final certo, não a velocidade de processar.
O depois: de caso específico a plataforma
O que nasceu para um caso virou base compartilhada: o time reescreveu o subsistema como uma plataforma de moderação genérica, com visual e configuração no-code, que atende também avaliação de foto de perfil, nome de usuário e review. Junto, normaliza agentes de moderação e cria um padrão reutilizável de governança por regra, e o coloca à prova constante com históricos reais. Para quem pensa em IA em produção no dia a dia, essa camada de governança operacional é o assunto da análise sobre como a OpenAI estruturou um modo dedicado para adolescentes, outro caso de moderação desenhada de forma não trivial, e da editoria de inteligência artificial.
O que aprender para o seu sistema
A lição prática para o time brasileiro é que o caminho barato para IA com impacto mensurável vem da engenharia. O SafeChat não gasta mais com modelo, gasta menos: barateou o que era trivial, cobrou só o que merecia LLM, e mediu o resultado final em vez do intermediário.
Se a sua operação inclui chat, comentário ou avaliação por texto ou imagem, essa é a abordagem de arquitetura que paga a conta pela redução de incidentes. A cobertura de IA aplicada a produto real está na editoria de mercado, e as posições abertas com esse tipo de stack, na lista de vagas.


